6.3 图的遍历·习题
复习入口
6.3 图的遍历 · 6.3.1 广度优先搜索 · 6.3.1.1 BFS 求无权图最短路径 · 6.3.1.2 广度优先生成树 · 6.3.2 深度优先搜索 · 6.3.3 图的遍历与图的连通性
本节共23题:选择题18题,综合应用题5题。每题答案紧接题目折叠显示。
文字转录进度:23/23题。已转录题目的题干、选项和解析可编辑;示意图按需保留。
单项选择题
单项选择题 01
原书题目P223 · 解析P226 · 目视转录
下列关于广度优先算法的说法中,正确的是( )。
Ⅰ.当各边的权值相等时,广度优先算法可以解决单源最短路径问题。
Ⅱ.当各边的权值不等时,广度优先算法可以用来解决单源最短路径问题。
Ⅲ.广度优先遍历算法类似于树中的后序遍历算法。
Ⅳ.实现图的广度优先算法时,使用的数据结构是队列。
A. Ⅰ、Ⅳ
B. Ⅱ、Ⅲ、Ⅳ
C. Ⅱ、Ⅳ
D. Ⅰ、Ⅲ、Ⅳ
查看答案与解析
答案:A。
广度优先搜索以起始结点为中心,一层一层向外层扩展遍历图的顶点,因此无法考虑到边权值,只适合求边权值相等的图的单源最短路径。广度优先搜索相当于树的层序遍历,Ⅲ错误。广度优先搜索需要用到队列,深度优先搜索需要用到栈,Ⅳ正确。
单项选择题 02
原书题目P223 · 解析P226 · 目视转录
下列关于图的说法中,错误的是( )。
Ⅰ.对一个无向图进行深度优先遍历时,得到的深度优先遍历序列是唯一的。
Ⅱ.若有向图不存在回路,即使不加访问标志位,同一结点也不会被访问两次。
Ⅲ.采用深度优先遍历方式或拓扑排序算法可以判断一个有向图中是否有环(回路)。
Ⅳ.对任何非强连通图必须 2 次或以上调用广度优先遍历算法才能访问所有的顶点。
A. Ⅰ、Ⅲ
B. Ⅱ、Ⅲ
C. Ⅰ、Ⅱ
D. Ⅰ、Ⅱ、Ⅳ
查看答案与解析
答案:D。
图的深度优先遍历序列通常是不唯一的,Ⅰ错误。考虑没有回路的有向图,弧为〈1,2〉、〈1,3〉、〈2,3〉:从顶点 1 开始深度优先遍历,若不设置访问标志位,则会重复访问顶点 3,Ⅱ错误。
深度优先遍历或拓扑排序算法可以判断有向图中是否有环,Ⅲ正确。有向图 1→2→3 不是强连通图,但从顶点 1 调用一次广度优先遍历算法就可访问所有顶点,Ⅳ错误。
单项选择题 03
原书题目P224 · 解析P226 · 目视转录
对于一个非连通无向图 G,采用深度优先遍历访问所有顶点,在 DFSTraverse 函数(见考点讲解 DFS 部分)中调用 DFS 的次数正好等于( )。
A. 顶点数
B. 边数
C. 连通分量数
D. 不确定
查看答案与解析
答案:C。
DFS(或 BFS)可用来计算无向图的连通分量数,因为一次遍历必然会将一个连通分量中的所有顶点都访问到,所以图的连通分量数正好是 DFSTraverse 中直接调用 DFS 的次数。
单项选择题 04
原书题目P224 · 解析P227 · 目视转录
对一个有 n 个顶点、e 条边的图采用邻接表表示时,进行 DFS 遍历的时间复杂度为( ),空间复杂度为( );进行 BFS 遍历的时间复杂度为( ),空间复杂度为( )。
A.
B.
C.
D.
查看答案与解析
答案:C、A、C、A。
深度优先遍历时,每个顶点表结点和每个边表结点均查找一次,每个顶点递归调用一次,需要借助一个递归工作栈;广度优先遍历时,也是每个顶点表结点和每个边表结点均查找一次,需要借助一个辅助队列。因此,两者的时间复杂度都是 ,空间复杂度都是 。
单项选择题 05
原书题目P224 · 解析P227 · 目视转录
图的广度优先遍历算法中使用队列作为其辅助数据结构,那么在算法执行过程中,每个顶点的入队次数最多为( )。
A. 1
B. 2
C. 3
D. 4
查看答案与解析
答案:A。
广度优先遍历中,每个顶点被访问后立即做访问标记并入队。若队列不空,则队首顶点出队;若该顶点的邻接顶点未被访问,则访问它,做访问标记并入队;若已访问过,则跳过。如此反复,直至队空。因此,每个顶点最多入队一次。
单项选择题 06
原书题目P224 · 解析P227 · 目视转录
对有 n 个顶点、e 条边的图采用邻接矩阵表示时,进行 DFS 遍历的时间复杂度为( ),进行 BFS 遍历的时间复杂度为( )。
A.
B.
C.
D.
查看答案与解析
答案:A、A。
采用邻接矩阵表示时,查找一个顶点所有出边的时间复杂度为 ,共有 n 个顶点,所以两种遍历的时间复杂度均为 。
单项选择题 07
原书题目P224 · 解析P227 · 目视转录
无向图 ,其中 ,。对该图从 a 开始进行深度优先遍历,得到的顶点序列正确的是( )。
A. a,b,e,c,d,f
B. a,c,f,e,b,d
C. a,e,b,c,f,d
D. a,e,d,f,c,b
查看答案与解析
答案:D。
画出草图后,此类题可以根据边的邻接关系快速排除错误选项。以 A 为例,在遍历到 e 之后,应访问与 e 邻接但未被访问的结点,而 (e,c) 显然不存在于边集中。
单项选择题 08
原书题目P224 · 解析P227 · 目视转录
如下图所示,在下面的 5 个序列中,符合深度优先遍历的序列个数是( )。
图的顶点为 a,b,c,d,e,f,无向边为 (a,b)、(a,e)、(a,c)、(b,e)、(e,d)、(e,f)、(d,f)。
- aebfdc
- acfdeb
- aedfcb
- aefdbc
- aecfdb
A. 5
B. 4
C. 3
D. 2
查看答案与解析
答案:D。
仅 1 和 4 正确。以 2 为例,遍历到 c 之后,与 c 邻接且未被访问的结点为空集,所以回溯到 a,接下来应为 a 的邻接点 b 或 e。以 3 为例,因为遍历要按栈返回,所以是先 b 后 c,不能先 c 后 b。
单项选择题 09
原书题目P224 · 解析P227 · 目视转录
用邻接表存储的图的深度优先遍历算法类似于树的( ),而其广度优先遍历算法类似于树的( )。
A. 中序遍历
B. 先序遍历
C. 后序遍历
D. 按层次遍历
查看答案与解析
答案:B、D。
图的深度优先搜索类似于树的先根遍历,即先访问结点,再递归向外层结点遍历,都采用回溯算法。图的广度优先搜索类似于树的层序遍历,即一层一层向外层扩展遍历,都需要采用队列来辅助算法实现。
单项选择题 10
原书题目P224 · 解析P227 · 目视转录
一个有向图 G 的邻接表存储如下,从顶点 1 出发,对图 G 调用深度优先遍历所得顶点序列是( );按广度优先遍历所得顶点序列是( )。
| 顶点 | 邻接表中依次排列的邻接点 |
|---|---|
| 1 | 2→4 |
| 2 | 5 |
| 3 | 6→5 |
| 4 | 2 |
| 5 | 4 |
| 6 | 6 |
A. 125436
B. 124536
C. 124563
D. 362514
查看答案与解析
答案:A、B。
DFS 序列产生的树边依次为〈1,2〉、〈2,5〉、〈5,4〉、〈3,6〉;BFS 序列产生的树边依次为〈1,2〉、〈1,4〉、〈2,5〉、〈3,6〉。
单项选择题 11
原书题目P225 · 解析P227 · 目视转录
无向图 ,其中 ,。对该图进行深度优先遍历,不能得到的序列是( )。
A. acfdeb
B. aebdfc
C. aedfcb
D. abecdf
查看答案与解析
答案:D。
画出 V 和 E 对应的图,然后根据搜索算法求解。
注意:本题序列不唯一,而上题序列唯一,是因为上题给出了具体的存储结构,必须按照算法过程执行,每个顶点的邻接点顺序已固定;本题中每个顶点的邻接点顺序未固定。
单项选择题 12
原书题目P225 · 解析P227 · 目视转录
判断有向图中是否存在回路,除拓扑排序外,还可以利用( )。(注:涉及下节内容。)
A. 求关键路径的方法
B. 求最短路径的 Dijkstra 算法
C. 深度优先遍历算法
D. 广度优先遍历算法
查看答案与解析
答案:C。
利用深度优先遍历可以判断图 G 中是否存在回路。对于无向图,若在深度优先遍历过程中遇到了回边,则必定存在环。对于有向图,这条回边可能指向深度优先森林中另一棵生成树上的顶点。但是,从有向图的某个顶点 v 出发进行深度优先遍历时,若在 DFS(v) 结束之前出现一条从顶点 u 到顶点 v 的回边,且 u 在生成树上是 v 的子孙,则有向图必定存在包含顶点 v 和顶点 u 的环。
单项选择题 13
原书题目P225 · 解析P227 · 目视转录
设无向图 和 ,若 G′ 是 G 的生成树,则下列说法错误的是( )。
A. G′ 为 G 的子图
B. G′ 为 G 的连通分量
C. G′ 为 G 的极小连通子图且 V=V′
D. G′ 是 G 的一个无环子图
查看答案与解析
答案:B。
连通分量是无向图的极大连通子图,其中“极大”的含义是将依附于连通分量中顶点的所有边都加上,所以连通分量中可能存在回路,这样就不是生成树了。
注意:极大连通子图是无向图(不一定连通)的连通分量,极小连通子图是连通无向图的生成树。“极小”和“极大”是在满足连通的前提下,针对边的数目而言的。极大连通子图包含连通分量的全部边;极小连通子图(生成树)包含连通图的全部顶点,且使其连通的边数最少。
单项选择题 14
原书题目P225 · 解析P228 · 目视转录
图的广度优先生成树的树高比深度优先生成树的树高( )。
A. 小或相等
B. 小
C. 大或相等
D. 大
查看答案与解析
答案:A。
对于无向图的广度优先搜索生成树,起点到其他顶点的路径是图中对应的最短路径,即所生成树的树高最小。此外,深度优先总是尽可能“深”地搜索图,因此其路径也尽可能长,所以深度优先生成树的树高总是大于或等于广度优先生成树的树高。
单项选择题 15
原书题目P225 · 解析P228 · 目视转录
【2012 统考真题】对有 n 个顶点、e 条边且使用邻接表存储的有向图进行广度优先遍历,其算法的时间复杂度是( )。
A.
B.
C.
D.
查看答案与解析
答案:C。
广度优先遍历需要借助队列实现。采用邻接表存储时,每个顶点入队一次(顶点被遍历),所需时间为 ;搜索所有顶点的邻接点过程中,每条边还会访问一次(出边表遍历),所需时间为 ,所以总时间复杂度为 。
单项选择题 16
原书题目P225 · 解析P228 · 目视转录
【2013 统考真题】下列选项中,不是如下无向图的广度优先遍历序列的是( )。
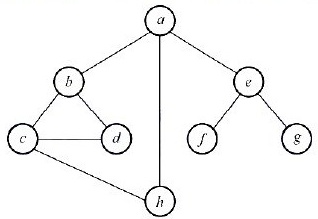
A. h,c,a,b,d,e,g,f
B. e,a,f,g,b,h,c,d
C. d,b,c,a,h,e,f,g
D. a,b,c,d,h,e,f,g
查看答案与解析
答案:D。
掌握 DFS 和 BFS 的遍历过程后,逐个代入、手工模拟即可。选项 D 是深度优先遍历序列,而不是广度优先遍历序列。
单项选择题 17
原书题目P225 · 解析P228 · 目视转录
【2015 统考真题】设有向图 ,顶点集 ,边集 。若从顶点 开始对图进行深度优先遍历,则可能得到的不同遍历序列个数是( )。
A. 2
B. 3
C. 4
D. 5
查看答案与解析
答案:D。
采用图的深度优先遍历,共有 5 种可能:〈v₀,v₁,v₃,v₂〉、〈v₀,v₂,v₃,v₁〉、〈v₀,v₂,v₁,v₃〉、〈v₀,v₃,v₂,v₁〉、〈v₀,v₃,v₁,v₂〉。
单项选择题 18
原书题目P225 · 解析P228 · 目视转录
【2016 统考真题】下列选项中,不是下图深度优先搜索序列的是( )。
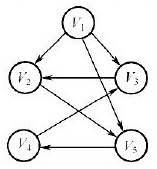
A. V₁,V₅,V₄,V₃,V₂
B. V₁,V₃,V₂,V₅,V₄
C. V₁,V₂,V₅,V₄,V₃
D. V₁,V₂,V₃,V₄,V₅
查看答案与解析
答案:D。
按深度优先遍历策略,选项 A 先访问 V₁,再访问与 V₁ 邻接且未被访问的任一顶点(V₂、V₃ 或 V₅),此时访问 V₅;从 V₅ 出发,未访问的邻接点只有 V₄;从 V₄ 出发,未访问的邻接点只有 V₃;从 V₃ 出发,未访问的邻接点只有 V₂,结束遍历。B、C 的分析方法相同。
对于 D,访问 V₁ 后访问 V₂,从 V₂ 出发未被访问的邻接点只有 V₅,按规则应当访问 V₅,但 D 却访问了 V₃,错误。
综合应用题
综合应用题 01
原书题目P225 · 解析P228 · 目视转录
图 以邻接表存储,如下表所示。试画出图 G 的深度优先生成树和广度优先生成树(假设从结点 1 开始遍历)。
| 顶点 | 邻接表中的邻接点顺序 |
|---|---|
| 1 | 2→3→4 |
| 2 | 1→3→4→5 |
| 3 | 1→2→4 |
| 4 | 1→2→3→5 |
| 5 | 2→4 |
查看答案与解析
根据邻接表可画出原图,其边为 (1,2)、(1,3)、(1,4)、(2,3)、(2,4)、(2,5)、(3,4)、(4,5)。
- 深度优先遍历总是尽可能“深”地搜索图。按该存储结构,搜索产生的树边依次为 (1,2)、(2,3)、(3,4)、(4,5),生成树是一条链 1—2—3—4—5。当存储结构固定时,生成树的树形也固定,例如不能搜索 (1,3)。
- 广度优先遍历总是尽可能“广”地搜索图,一层一层向外扩展。搜索产生的树边依次为 (1,2)、(1,3)、(1,4)、(2,5)。生成树如下。
    1
  / | \
 2  3  4
 |
 5
综合应用题 02
原书题目P226 · 解析P229 · 目视转录
给定一个连通无向图,采用邻接表存储,将图的所有顶点分别染成红色或蓝色。若存在一种染色方法使图中每条边的两个顶点的颜色都不相同,则称这个图能被二分。
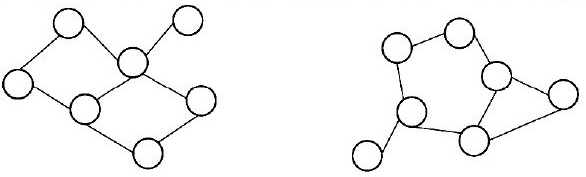
- 判断上面两个无向图是否能被二分。若能被二分,则请标出每个顶点的颜色。
- 请设计一种算法来判断图是否能被二分,仅用语言描述算法思想即可。
- 给出你所设计的算法的时间复杂度和空间复杂度。
查看答案与解析
- 右图不能被二分,左图能被二分。左图可将最上方左、右两个顶点、最右顶点以及左下方中间顶点染成红色;将最左顶点、中央顶点和最下顶点染成蓝色。这样每条边的两个端点颜色都不同。
- 从任意一个结点开始,将其染成红色,并从该结点开始对整个图遍历。当当前遍历的结点 a 有一条边指向 b 时,可能出现三种情况:① b 未被染色,则将其染成与 a 不同的颜色,并继续遍历与 b 相连的结点;② a 与 b 颜色相同,说明该图不能被二分,直接返回;③ a 与 b 颜色不同,跳过 b。
- 无论使用深度优先还是广度优先遍历,时间复杂度均为 ,其中 n、m 分别是顶点数和边数。用数组存储各结点的颜色及是否已访问,空间复杂度为 。
综合应用题 03
原书题目P226 · 解析P229 · 目视转录
试设计一个算法,判断一个无向图 G 是否为一棵树。若是一棵树,则算法返回 true,否则返回 false。
查看答案与解析
无向图 G 是一棵树的条件是:G 是无回路的连通图,或是有 n−1 条边的连通图。这里采用后者作为判断条件。对连通性的判定,可用一次遍历访问全部顶点来实现。在深度优先遍历中统计能访问到的顶点个数及边的条数;若一次遍历能访问到 n 个顶点和 n−1 条边,则可断定该图是一棵树。
bool IsTree(Graph G) {
    for (int i = 1; i <= G.vexnum; ++i)
        visited[i] = FALSE;             // 访问标记初始化
    int Vnum = 0, Enum = 0;             // 记录顶点数和边计数
    DFS(G, 1, Vnum, Enum, visited);
    if (Vnum == G.vexnum && Enum == 2 * (G.vexnum - 1))
        return true;                   // 符合树的条件
    else
        return false;
}

void DFS(Graph &G, int v, int &Vnum, int &Enum, int visited[]) {
    // 统计访问过的顶点数和边计数,通过 Vnum 和 Enum 返回
    visited[v] = TRUE;
    Vnum++;
    int w = FirstNeighbor(G, v);
    while (w != -1) {
        Enum++;                        // 无向边从两个端点各计一次
        if (!visited[w])
            DFS(G, w, Vnum, Enum, visited);
        w = NextNeighbor(G, v, w);
    }
}
综合应用题 04
原书题目P226 · 解析P229 · 目视转录
分别采用基于深度优先遍历和广度优先遍历的算法,判别以邻接表方式存储的有向图中是否存在由顶点 到顶点 的路径(i≠j)。注意,算法中涉及的图的基本操作必须在此存储结构上实现。
查看答案与解析
两个算法都从顶点 出发,依次遍历图中每个顶点,直到搜索到 。若能搜索到,说明存在由 到 的路径。
深度优先遍历算法如下。
int visited[MAXSIZE] = {0};
void DFS(ALGraph G, int i, int j, bool &can_reach) {
    // 用 can_reach 标识是否有从 vi 到 vj 的路径
    if (i == j) {
        can_reach = true;
        return;
    }
    visited[i] = 1;
    for (int p = FirstNeighbor(G, i); p >= 0;
         p = NextNeighbor(G, i, p))
        if (!visited[p] && !can_reach)
            DFS(G, p, j, can_reach);
}
广度优先遍历算法如下(visited 在调用前重新初始化)。
int visited[MAXSIZE] = {0};
int BFS(ALGraph G, int i, int j) {
    // 有路径返回 1,否则返回 0
    InitQueue(Q);
    EnQueue(Q, i);
    while (!isEmpty(Q)) {
        DeQueue(Q, i);
        visited[i] = 1;
        if (i == j) return 1;
        for (int p = FirstNeighbor(G, i); p;
             p = NextNeighbor(G, i, p)) {
            if (p == j)
                return 1;
            if (!visited[p]) {
                EnQueue(Q, p);
                visited[p] = 1;
            }
        }
    }
    return 0;
}
也可调用以 i 为参数的 DFS(G,i) 或 BFS(G,i),执行结束后判断 visited[j] 是否为 TRUE。若是,说明 已被遍历,图中存在由 到 的路径。但这种方法每次都耗费最坏时间复杂度对应的时间,需要遍历与 连通的所有顶点。
转录核对:原书 DFS 以 −1 表示不存在邻接点,而 BFS 的 for 条件写作
p。实际使用时,应按邻接点接口约定统一结束条件;若使用 −1,应写成p >= 0。本题限定邻接表,可用边结点指针扫描同一条链表来实现邻接点枚举。
综合应用题 05
原书题目P226 · 解析P230 · 目视转录
假设图用邻接表表示,设计一个算法,输出从顶点 到顶点 的所有简单路径。
查看答案与解析
采用基于递归的深度优先遍历。从结点 u 出发递归遍历,若访问到 v,则输出该搜索路径上的结点。设置 path 数组存储路径上的结点(初始为空),d 表示路径长度(初始为 −1)。查找 u 到 v 的简单路径的递归过程如下(设函数名为 FindPath)。
- FindPath(G,u,v,path,d):d++,path[d]=u;若找到 u 的未访问过的相邻结点 u₁,则继续下去,否则置 visited[u]=0 并返回。
- FindPath(G,u₁,v,path,d):d++,path[d]=u₁;若找到 u₁ 的未访问过的相邻结点 u₂,则继续下去,否则置 visited[u₁]=0。
- 依此类推,继续递归,直到 uᵢ=v,输出 path。
void FindPath(AGraph *G, int u, int v, int path[], int d) {
    int w;
    ArcNode *p;
    d++;                               // 路径长度增 1
    path[d] = u;                       // 当前顶点添加到路径中
    visited[u] = 1;                    // 置已访问标记
    if (u == v)
        print(path[]);                 // 找到一条路径,输出路径结点
    p = G->adjlist[u].firstarc;
    while (p != NULL) {
        w = p->adjvex;
        if (visited[w] == 0)
            FindPath(G, w, v, path, d);
        p = p->nextarc;
    }
    visited[u] = 0;                    // 恢复环境,使该顶点可重新使用
}
print(path[]) 是原书表示“输出当前路径”的伪代码,应输出 path[0..d]。